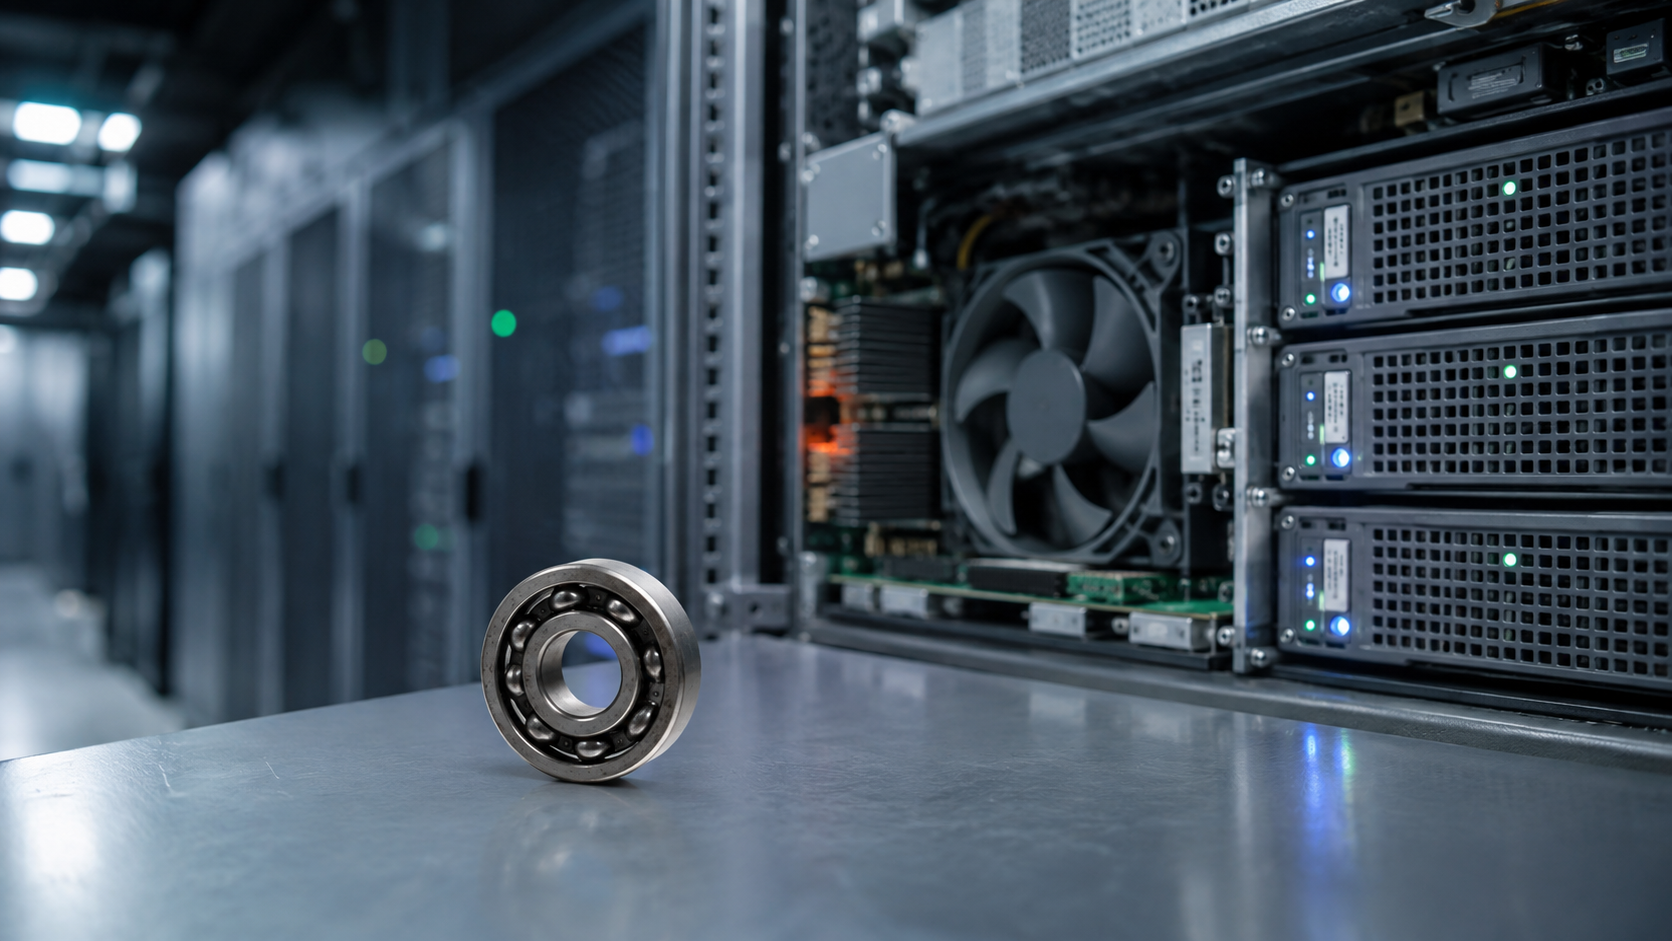
Questa settimana, nella nostra infrastruttura interna, un cuscinetto a sfera da 0,02 € guasto ha innescato una reazione a catena che ha coinvolto uno dei tre ipervisori di un cluster interno. Nessun cliente e nessun dipendente è stato maltrattato, perché gli altri due ipervisori del cluster hanno assorbito il carico grazie alla ridondanzaPresenza di risorse duplicate (es. più server nello stesso cluster) pronte a subentrare se una di esse si guasta, senza interrompere il servizio.. I sistemi di monitoraggio hanno segnalato l'anomalia al team tecnico, consentendo di intervenire per tempo senza che utenti o clienti subissero disservizi. È la dimostrazione pratica di cosa significhi davvero fare business continuityCapacità di un'azienda di continuare a erogare i propri servizi anche durante un'interruzione o un guasto grave. e disaster recoveryInsieme di procedure tecniche per ripristinare sistemi e dati dopo un evento che li ha resi inutilizzabili.: non un costo da tagliare, ma un piano da costruire prima che serva.
L'effetto domino: dal cuscinetto al cluster
La catena dei fatti, ricostruita insieme al nostro team tecnico, parte da un componente talmente piccolo da sembrare irrilevante. Ed è proprio questo il punto: in un sistema complesso, non è la grandezza del guasto iniziale a contare, ma la lunghezza della catena di dipendenze che lo separa dal danno finale.
1Un cuscinetto a sfera si sporca e si guasta0,02 €
2La ventola che dipende dal cuscinetto si blocca8,00 €
3La scheda si surriscalda e si blocca, entrambe interne all'ipervisore60,00 €
4L'intero ipervisoreSoftware o macchina fisica che gestisce più macchine virtuali su un unico server. si blocca8.000,00 €
5L'ipervisore esce dal clusterGruppo di più server collegati tra loro che lavorano insieme per garantire continuità di servizio., ma gli altri due lo assorbono24.000,00 €
Va precisato un dettaglio tecnico importante: cuscinetto, ventola e scheda non sono tre componenti esterni e separati. Sono tutti fisicamente interni allo stesso ipervisore. È il guasto interno di quella singola macchina a propagarsi verso l'alto, fino a farla uscire completamente dal cluster di cui faceva parte, un cluster da 24.000,00 € composto da tre nodi.
Componente coinvolto
Valore indicativo
Ruolo nella catena
Cuscinetto a sfera
0,02 €
Innesco del guasto
Ventola di raffreddamento
8,00 €
Si blocca per il cuscinetto guasto
Scheda interna all'ipervisore
60,00 €
Si inchioda per il surriscaldamento
Ipervisore
8.000,00 €
Va completamente fuori servizio
Cluster di 3 ipervisori
24.000,00 €
Regge grazie alla ridondanza degli altri due nodi
Vista esplosa: segui il guasto passo dopo passo
●Cuscinetto a sfera 0,02 €
↓
✳Ventola 8,00 €
↓
▭Scheda interna 60,00 €
↓
▣IPERVISORE 8.000,00 €
↓
▤1 IPERVISORE ESCE DAL CLUSTER su 3 nodi · cluster da 24.000,00 €
↓
✓RIDONDANZA ATTIVA gli altri 2 ipervisori assorbono il carico, nessun disagio
Clicca su "Avvia il guasto" per vedere la cascata, dal cuscinetto al cluster.
Perché la ridondanza del cluster ha salvato tutto
Il punto centrale della storia non è il guasto, che può capitare, ma quello che non è successo dopo. Il cluster coinvolto era progettato in ridondanzaPresenza di risorse duplicate, in questo caso più server nello stesso cluster, pronte a coprire il carico se una di esse si guasta senza interrompere il servizio.: quando l'ipervisore guasto è uscito di scena, gli altri due nodi del cluster hanno assorbito il carico che gestiva. Questo ha impedito qualunque interruzione ai servizi condivisi, e ha permesso a tutti i dipendenti di continuare a lavorare senza percepire alcun disagio.
È l'esempio più concreto possibile di un principio che ripetiamo spesso durante le verifiche che effettuiamo per i clienti: separare i sistemi critici, non tenerli tutti sullo stesso piano di rischio, è una delle misure di disaster recovery più efficaci e meno costose da implementare, perché non richiede nuovo hardware, ma progettazione.
Prova tu: cosa sarebbe cambiato senza ridondanza?
Quello che è successo davvero
Il cluster era progettato con un nodo in più rispetto al minimo necessario. Quando uno dei tre ipervisori è andato in fault, gli altri due hanno assorbito il carico senza interruzioni: nessun servizio ne ha risentito e i dipendenti hanno continuato a lavorare. I sistemi di monitoraggio hanno segnalato l'anomalia al team tecnico, permettendo di intervenire per tempo e gestire il ripristino senza la pressione di utenti o clienti bloccati.
Cosa sarebbe potuto succedere senza ridondanza
Se lo stesso carico fosse stato distribuito su un unico server, senza nodi di riserva, lo stesso guasto avrebbe fermato subito il servizio che quel server gestiva. Il problema sarebbe stato rilevato solo al momento del blackout, con utenti e clienti già bloccati, costringendo i tecnici a intervenire sotto pressione invece che con un ripristino pianificato con calma.
★ Alchimie Digitali su Google
Ti piace Alchimie Digitali? Aggiungilo alle tue fonti preferite su Google
Se vuoi trovare più facilmente i nostri approfondimenti su cybersecurity, infrastruttura IT e compliance, puoi scegliere Alchimie Digitali tra le tue fonti preferite su Google.
I sistemi di monitoraggio dell'infrastruttura hanno rilevato l'anomalia e avvertito il team tecnico, permettendo di intervenire per tempo e avviare subito le attività di diagnosi e ripristino. Nel frattempo, la ridondanza del cluster ha continuato a garantire l'operatività senza disservizi percepibili per utenti e clienti.
Una volta individuato, il ripristino completo ha richiesto circa due giorni pieni di lavoro da parte di due tecnici senior. Non un intervento banale: prima è stato necessario diagnosticare con precisione dove si trovasse il problema all'interno della catena hardware, risalendo fino al cuscinetto. Poi, grazie a una risorsa interna specializzata in elettrotecnica, è stato possibile smontare minuziosamente la ventola, pulirla, ingrassare il cuscinetto e rimontare tutto, riportando il componente perfettamente funzionante invece di doverlo sostituire. È un dettaglio che spesso viene sottovalutato quando si parla di disaster recovery: anche un piano ben progettato richiede tempo e competenza specialistica per essere eseguito, non è un pulsante da premere.
La lezione di disaster recovery: la business continuity non si improvvisa
Il costo dei componenti coinvolti in questa vicenda, dai due centesimi del cuscinetto ai 24.000,00 € del cluster, non è il punto. Il punto è che nessuna di queste cifre racconta davvero il rischio reale, che è sempre lo stesso: cosa succede quando un guasto, piccolo o grande, arriva davvero. Risparmiare su ridondanza, backup e monitoraggio funziona benissimo finché tutto va bene. Il problema è che prima o poi qualcosa si guasta, ed è proprio in quel momento che si scopre se l'azienda ha un piano oppure no.
Le infrastrutture migliori non sono quelle che non subiscono mai un danno, ma quelle che non crollano quando il danno arriva. È questa la differenza tra chi ha un piano di disaster recovery e chi si limita a sperare che non succeda nulla.
Costruire una strategia di business continuityCapacità di un'azienda di continuare a erogare i propri servizi anche durante un'interruzione o un guasto grave. seria richiede tempo, investimento e programmazione, non improvvisazione dell'ultimo momento. Non a caso lo standard internazionale ISO 22301 è quello specificamente dedicato ai sistemi di gestione della continuità operativa e definisce la continuità come la capacità di un'organizzazione di continuare a erogare prodotti e servizi entro tempi accettabili durante un'interruzione, attraverso un processo continuo di pianificazione, verifica e miglioramento, non attraverso interventi una tantum. La ISO/IEC 27001, pur essendo dedicata alla gestione della sicurezza delle informazioni, è strettamente collegata al tema perché comprende controlli relativi alla sicurezza delle informazioni durante le interruzioni e alla prontezza ICT per la business continuity. La ISO 9001, invece, non è uno standard specifico di business continuity, ma contribuisce sul piano della gestione del rischio e del controllo dei processi. È anche per questo che il nostro percorso verso le certificazioni ISO 9001 e ISO/IEC 27001 si inserisce in una visione più ampia di resilienza e continuità aziendale, senza sostituire il ruolo specifico della ISO 22301.
Lo stesso principio è oggi anche un obbligo normativo per molte imprese italiane: la direttiva NIS2 richiede esplicitamente alle entità coinvolte di dotarsi di piani documentati di continuità operativa e disaster recovery, con backup adeguati e livelli di ridondanza sufficienti a garantire la ripresa dei servizi in caso di incidente. Un cluster ridondante che continua a garantire l'operatività mentre i sistemi di monitoraggio segnalano l'anomalia al team tecnico è, in piccolo, esattamente il tipo di resilienza che queste normative chiedono di costruire.
I nostri servizi per una vera continuità operativa
Su questi principi lavoriamo ogni giorno con i nostri clienti. Ecco i servizi di Alchimie Digitali più legati a quanto raccontato in questo articolo.
Quattro pezzi dello stesso puzzle: nessuno basta da solo, insieme costruiscono la continuità operativa.
Domande frequenti sul caso
Perché un componente da pochi centesimi ha potuto mettere a rischio un cluster da 24.000,00 €?
Perché in un sistema informatico i componenti sono collegati da relazioni di dipendenza fisica e funzionale. Un cuscinetto guasto ha bloccato la ventola, la ventola bloccata ha fatto surriscaldare una scheda interna all'ipervisore, e il blocco della scheda ha fatto cadere prima l'ipervisore e poi l'intero cluster a cui apparteneva.
Perché utenti e dipendenti non hanno percepito il guasto?
Perché gli altri due ipervisori del cluster hanno assorbito il carico di quello guasto grazie alla ridondanza, evitando interruzioni del servizio. Questo non significa che il problema sia passato inosservato: i sistemi di monitoraggio hanno segnalato l'anomalia al team tecnico, consentendo di intervenire per tempo.
Quanto tempo serve per risolvere un guasto hardware di questo tipo?
In questo caso circa due giorni pieni di lavoro da parte di due tecnici senior, tra diagnosi e intervento, a causa della complessità nel risalire alla causa reale del blocco.
Che ruolo ha avuto il sistema di monitoraggio?
Il monitoraggio dell'infrastruttura ha funzionato come previsto: ha segnalato l'anomalia al team tecnico e ha permesso di intervenire per tempo, prima che il problema potesse trasformarsi in un disservizio percepibile da utenti o clienti.
Altre domande correlate
Cos'è un piano di business continuity?
È l'insieme di procedure e strategie che permettono a un'azienda di continuare a operare, o di riprendere rapidamente a farlo, durante e dopo un evento che interrompe i sistemi o i processi critici.
Cosa si intende per ridondanza di un'infrastruttura IT?
Significa progettare più risorse del minimo necessario, ad esempio un server in più in un cluster, così che se una di esse si guasta le altre possano assorbirne il carico senza interrompere il servizio.
La NIS2 obbliga le aziende ad avere un piano di disaster recovery?
Sì, per le entità che rientrano nel suo perimetro. La direttiva NIS2 richiede piani documentati di continuità operativa e ripristino, oltre a backup adeguati e livelli di ridondanza sufficienti a garantire la ripresa dei servizi.
Il tuo piano di business continuity regge davvero un guasto imprevisto, o funziona solo finché non succede niente?
Come comprare un SSD davvero affidabile (e non quello che il marketing vuole venderti)
Versione divulgativa — per esseri umani normali, non informatici, che però vogliono capire davvero.
Sintesi ragionata e ampliata di due articoli: "How to buy a reliable SSD" di Vitaliy Mokosiy
(Atola, LinkedIn)
e la replica "How to Buy a Reliable SSD, Continued" di Oleg Afonin
(Elcomsoft, 2 luglio 2026).
Due esperti che maneggiano SSD morti per mestiere, il CTO di un'azienda di hardware forense
e un ricercatore di Elcomsoft, si confrontano pubblicamente su come si compra davvero un
SSD affidabile: il primo propone una checklist, il secondo la mette sotto esame punto per
punto e mostra dove non basta.
Gli SSD, a differenza dei vecchi hard disk, quasi mai permettono di recuperare i dati
dopo un guasto: il backup 3-2-1 testato è l'unico vero paracadute.
La stessa scheda tecnica può nascondere memoria, controller o firmware diversi a seconda
del taglio o del lotto di produzione: verificare il modello specifico conta più del marchio.
Il caso Samsung 990 Pro mostra che anche un disco che rispetta ogni singolo criterio di
una checklist solida può comunque avere un problema serio: nessuna checklist elimina del
tutto il rischio.
Il criterio più utile per scegliere un produttore non è "esiste un tool di aggiornamento
firmware?" ma "quanto tempo impiega, storicamente, a correggere i problemi quando emergono?"
Capitolo 0 — Chi sono questi due, e perché dovresti ascoltarli
Partiamo da qui, perché su internet chiunque ha un'opinione sugli SSD, di solito basata su "a me
il Samsung non si è mai rotto" (campione statistico: uno).
Questi due non sono chiunque.
Vitaliy Mokosiy è il CTO di Atola Technology, un'azienda che
costruisce hardware forense: le macchine che polizie, laboratori di recupero dati e periti di
mezzo mondo usano per fare copie bit-a-bit di dischi, inclusi quelli danneggiati, in modo che il
contenuto regga in tribunale. Quando un disco arriva sul suo banco, di solito è perché qualcosa
è andato molto storto. Atola vede il pronto soccorso dei dischi: sa come muoiono, e in
che compagnia.
Oleg Afonin lavora per Elcomsoft, storica azienda di sicurezza
informatica e strumenti forensi (recupero password, estrazione dati da dispositivi mobili,
analisi di supporti cifrati). Elcomsoft ha una tradizione decennale di articoli che smontano gli
SSD fino al singolo chip — hanno documentato
perché gli SSD muoiono di colpo
e
come identificare cosa c'è davvero dentro un disco
quando l'etichetta non lo dice.
Quindi: quando questi due discutono su come si compra un SSD affidabile, non è una rissa da
forum. È un dibattito tra persone che gli SSD morti li maneggiano per mestiere. Il primo ha
scritto una checklist; il secondo ha risposto — con rispetto, ma con il bisturi — "tutto vero, ma
ti sei tenuto le informazioni migliori in tasca". E leggendo lo scambio con umiltà, si impara più
che da cento recensioni.
Capitolo 1 — Prima di tutto: devi disimparare il disco rigido
Se hai più di trent'anni, la tua idea di "disco del computer" si è formata sui
dischi rotazionali: quelli con dentro dei piatti metallici ricoperti di materiale
magnetico, che girano a 5.400 o 7.200 giri al minuto, con una testina che vola sopra la
superficie a leggere e scrivere. Un giradischi molto nevrotico, in sostanza.
Quel disco lì aveva una proprietà che davamo per scontata, e che non ci siamo mai presi la
briga di ringraziare: si rompeva in modo gentile.
Spesso avvisava: click, ronzii, rallentamenti, settori che cominciavano a dare
errori. Avevi giorni, a volte settimane, per correre ai ripari.
E soprattutto: i dati e l'elettronica abitavano in posti diversi. I dati
stavano sui piatti magnetici; l'elettronica stava su una scheda avvitata sotto. Se moriva la
scheda, i piatti erano quasi sempre intatti: un laboratorio serio trasferiva i piatti in un
disco donatore identico (in camera bianca, con costi non banali, ma con ottime probabilità) e i
tuoi dati tornavano a casa. Il guasto elettronico e la perdita dei dati erano due eventi
separati.
Con gli SSD, questo patto è stato stracciato. E nessuno ce l'ha detto
chiaramente al momento della firma.
In un SSD i dati non stanno "da qualche parte" in modo ordinato e leggibile. Stanno
sparpagliati su decine di chip di memoria, in un ordine che ha senso solo per il
controller — il piccolo processore del disco — e per la sua
mapping table, la mappa segreta che dice "il file che il computer chiama X sta
fisicamente nei pezzetti Y, Z, W, sparsi qua e là". Questa mappa viene riscritta di continuo,
perché l'SSD sposta costantemente i dati per distribuire l'usura delle celle. In più, quasi
tutti gli SSD moderni cifrano tutto internamente sempre e comunque, anche se tu
non hai mai impostato una password: la chiave vive nel controller.
Ora fai morire il controller — che è esattamente il componente che di solito muore. Che cosa
resta? Decine di chip pieni di coriandoli cifrati, senza la mappa per rimetterli in ordine e
senza la chiave per leggerli. Il recupero, quando è possibile, richiede laboratori con
attrezzature da decine di migliaia di euro, competenze rarissime, e spesso finisce comunque con
un "ci dispiace". Non è più "smonto i piatti e li leggo altrove": è un miracolo di quelli buoni,
di una qualche forma di dio dell'informatica, in un giorno di grazia assoluta. E i miracoli,
notoriamente, non si prenotano.
E c'è di peggio: l'SSD tende a morire di colpo. Un secondo prima funziona, un
secondo dopo il BIOS non lo vede più. Niente click di avvertimento, niente settimane di
preavviso. A volte, come estrema cortesia, si mette in sola lettura e ti lascia evacuare i dati.
A volte no.
Quindi fissiamo il primo concetto, quello che regge tutto il resto:
Gli SSD ci hanno regalato una velocità meravigliosa, ma non è stata gratis. In cambio
abbiamo lasciato sul tavolo la recuperabilità. Quando compri un SSD risparmiando 50
euro sul modello giusto o mezza giornata di ricerca, stai facendo una scommessa. E se un giorno
passa a trovarti la Totally Fucked Up Fairy — la fatina che non porta monetine ma si
porta via i tuoi dati — quei 50 euro e quella mezza giornata li rimpiangerai con una intensità
difficile da descrivere a chi non c'è passato.
Capitolo 2 — Il backup non è un consiglio. E comunque non ti serve il backup: ti serve il restore
Ogni guida sugli SSD contiene la frase "ricordati di fare il backup", messa lì come "lavati i
denti". Tutti annuiscono, quasi nessuno lo fa, e chi lo fa spesso lo fa male. Quindi mettiamola
giù in modo diverso, perché dopo il Capitolo 1 dovrebbe essere chiaro il contesto:
con gli SSD, il backup non è un consiglio igienico. È l'unico paracadute che hai.
Il piano B "male che vada lo porto in laboratorio" con gli SSD è quasi sempre una fantasia.
Ma c'è un secondo livello, quello che separa gli adulti dai turisti:
a nessuno interessa il backup. Interessa il restore.
Il backup è un mezzo. Quello che vuoi davvero è: quando il disco muore, in quanto tempo e
con quanta completezza torno operativo? E qui succedono cose interessanti:
C'è chi "il backup ce l'ha" — su un disco esterno mai verificato, con un software che ha
smesso silenziosamente di girare otto mesi fa dopo un aggiornamento di Windows.
C'è chi il backup ce l'ha davvero, integro, nel cloud… e scopre il giorno del disastro che
riscaricare 2 TB con la sua connessione richiede dieci giorni. Il backup c'era. Il restore
arriva quando ormai il danno lo hai pagato tutto.
C'è chi ha tutto, ma non ha mai provato la procedura, e la prima prova generale la
fa nel giorno peggiore della sua vita informatica, imparando in diretta che mancava proprio
quella cartella lì.
Da cui la regola, che vale per il privato con le foto dei figli e per l'azienda con il gestionale:
Un backup non testato è una speranza, non un backup. Programma test di restore
periodici: prendi un file a caso, o una cartella, o (per i più seri) un'intera macchina, e
riportala in vita. Cronometra. Se il tempo di restore è incompatibile con quanto puoi
permetterti di stare fermo, il tuo backup è sbagliato anche se funziona — perché stare
fermi è un'attività parecchio costosa, e di solito lo si scopre a tariffa piena.
Lo schema minimo resta il 3-2-1: tre copie dei dati, su due tipi di supporto
diversi, di cui una fuori sede (cloud o fisicamente altrove). Ma il vero indicatore di qualità
non è "quante copie ho": è "quando ho fatto l'ultimo test di restore, e quanto ci ha messo".
Tenete a mente questo capitolo: quando più avanti Afonin liquiderà il punto "fate il backup"
della checklist come vero ma inutile, capirete che non sta dicendo che il backup non
serve. Sta dicendo che scriverlo in fondo a una checklist non ha mai convertito nessuno. Questo
capitolo è il tentativo di convertirvi prima.
Capitolo 3 — Se costa di meno, non sei più furbo tu
Ultimo concetto preliminare, poi apriamo il paziente.
Il mercato degli SSD è maturo, ipercompetitivo, con margini risicati. In un mercato così,
i pasti gratis non esistono. Due dischi che sulla scatola dichiarano gli stessi
numeri, ma costano 89 e 129 euro, non sono "lo stesso disco, uno scontato". Sono due dischi
diversi, e la differenza sta esattamente nei posti che la scatola non menziona: il tipo di
memoria, il processore interno, la presenza o assenza di certi componenti, la cura del
firmware, il controllo qualità dei lotti.
Se costa di meno, non è che tu sei più furbo. È che di solito vale di meno — e tu non
hai (ancora) gli strumenti per capire perché. Il risparmio non sparisce: si trasforma.
In velocità che crolla a metà di una copia grossa, in una lotteria su cosa c'è dentro, in un
firmware che nessuno aggiornerà mai, in un disco che muore a 13 mesi con 12 mesi di garanzia
del negozio.
Attenzione, il teorema non funziona al contrario: spendere tanto non garantisce
niente (lo dimostreremo con un flagship Samsung tra qualche capitolo). Ma spendere poco
garantisce quasi sempre qualcosa: che da qualche parte, qualcuno, ha tagliato. Lo scopo
di questa guida è darti gli occhiali per vedere dove.
Capitolo 4 — L'anatomia di un SSD, spiegata a un essere umano
Ora apriamo il disco. Un SSD è composto da quattro cose che contano, più una manciata di sigle
che il marketing usa per stordirti. Andiamo con calma.
4.1 La NAND flash: dove abitano i tuoi dati
La memoria di un SSD è fatta di miliardi di microscopiche celle, ognuna delle
quali trattiene una carica elettrica. Immagina ogni cella come un minuscolo secchiello d'acqua:
il livello dell'acqua rappresenta l'informazione.
Qui arriva l'idea che ha reso gli SSD economici, e insieme il primo grande compromesso. Nei
primi SSD ogni secchiello memorizzava 1 bit: pieno o vuoto, facilissimo da
leggere anche se un po' d'acqua evapora. Poi qualcuno ha pensato: e se distinguessimo
quattro livelli d'acqua nello stesso secchiello? Ecco 2 bit per cella,
stessa quantità di silicio, doppia capacità. Poi otto livelli (3 bit), poi sedici livelli
(4 bit).
Il problema è intuitivo: distinguere "pieno/vuoto" è facile; distinguere sedici livelli in un
secchiello che perde qualche goccia per usura e temperatura è un lavoro da orefice. Più livelli
significa:
scritture più lente (bisogna dosare l'acqua con precisione crescente);
più errori da correggere in lettura;
celle che si usurano prima, perché ogni scrittura stressa fisicamente la
cella e una cella stressata distingue sempre peggio i livelli.
La tabella che ne esce è questa, ed è la spina dorsale di tutta la guida:
Sigla
Bit per cella
Livelli da distinguere
Cicli di scrittura (ordine di grandezza)
Traduzione
SLC
1
2
~100.000
La nobiltà. Oggi solo industriale (e come "trucco", vedi cache)
MLC
2
4
~10.000
Praticamente estinta nel consumer
TLC
3
8
~1.000–3.000
Lo standard consumer di qualità. Quello che vuoi.
QLC
4
16
~500–1.000
La fascia economica. Più capacità, meno tutto il resto
Nota bene: la QLC non è "rotta". Per un archivio di foto che scrivi una volta e leggi per anni,
va benissimo. Il problema è quando te la vendono senza dirtelo al posto della TLC — e
su questo torneremo, perché è la fregatura numero uno del mercato.
4.2 Il controller: il cervello (e il punto debole)
Il controller è un piccolo processore che sta tra il computer e le celle di
memoria, e fa un lavoro sorprendentemente complicato:
Traduce gli indirizzi. Il sistema operativo crede che il file stia "al
posto 4.512". In realtà il controller lo ha spezzato e sparso su celle diverse, e tiene la
corrispondenza in una mapping table (tabella di mappatura) — l'elenco
telefonico che collega il mondo logico a quello fisico. Senza questa tabella, i dati sono
coriandoli.
Distribuisce l'usura (wear leveling). Poiché ogni cella sopporta
un numero limitato di scritture, il controller sposta continuamente i dati per consumare le
celle in modo uniforme, come un padrone di casa che fa ruotare gli ospiti sulle sedie perché
nessuna si sfondi prima delle altre.
Corregge gli errori. Ricordi i sedici livelli d'acqua? Il controller passa
la vita a correggere letture incerte con algoritmi di correzione d'errore. Più la NAND è densa
e usurata, più lavora.
Cifra tutto, di serie, con una chiave che vive dentro di lui.
Il controller è anche il componente che scalda e quello che statisticamente
muore per primo. E quando muore, muore con la mappa e con la chiave in tasca. Ecco perché il
Capitolo 1 diceva quello che diceva.
4.3 Il firmware: il software segreto che decide tutto
Il controller esegue un programma: il firmware. È il software interno del
disco, quello che implementa tutte le strategie viste sopra. E qui c'è un concetto che il
consumatore medio ignora completamente:
Due dischi con hardware identico e firmware diverso sono due dischi diversi.
Un bug nel firmware può azzoppare o uccidere un disco fisicamente perfetto. Un aggiornamento
può salvarlo. Il firmware è l'anima del disco, e non la vedi da fuori.
Tienilo a mente: il caso più clamoroso degli ultimi anni (il Samsung 990 Pro) è una storia di
firmware, non di hardware. Ci arriviamo.
4.4 La cache pSLC: il trucco di prestidigitazione sulla scatola
Adesso ti spiego da dove viene il numero gigante stampato sulla confezione ("7.400 MB/s!"), e
perché è contemporaneamente vero e fuorviante.
Ricordi che le celle SLC (1 bit, 2 livelli) sono velocissime? I produttori usano un trucco
elegante: prendono una porzione della NAND TLC o QLC del disco e la fanno lavorare
temporaneamente in modalità SLC — un bit per cella, riempimento grezzo, velocità
massima. Si chiama cache pSLC (pseudo-SLC). Quando scrivi, i dati entrano
prima lì, a razzo; poi, con calma, il controller li travasa nella NAND "vera" a 3 o 4 bit per
cella.
Funziona benissimo… finché la cache non si riempie. Copia 10 GB e non te ne accorgi. Copia
100 GB — un backup, un progetto video, una libreria di giochi — e a un certo punto la cache è
piena, il travaso non tiene il passo, e il disco è costretto a scrivere direttamente sulla
NAND nuda. Lì crolla la maschera:
un buon TLC scende a velocità comunque dignitose (spesso 1.000–2.000
MB/s);
un QLC economico può precipitare a 100–400 MB/s — velocità da disco
rotazionale del 2010, su un oggetto che sulla scatola prometteva 70 volte tanto.
La velocità sulla scatola è la velocità della cache. La velocità
sostenuta — quella che conta quando muovi tanti dati — spesso non è nemmeno
dichiarata. Non è un caso.
4.5 DRAM e HMB: la storia della "cache che devi avere" (spoiler: dipende)
Alcuni SSD hanno a bordo un chip di DRAM — memoria RAM velocissima — usata
principalmente per tenere a portata di mano la mapping table (l'elenco telefonico del punto
4.2), così il controller non deve consultarla nella NAND, più lenta.
Per anni la regola dei forum è stata: "senza DRAM non comprarlo". Aveva senso nell'era dei
dischi SATA. Oggi molto meno, perché i dischi NVMe moderni senza DRAM usano l'HMB
(Host Memory Buffer): prendono in prestito una piccola fetta della RAM del tuo computer
per lo stesso scopo. Risultato pratico, per l'uso normale: una differenza che si misura nei
benchmark e non si sente nell'uso. Ne riparliamo nella checklist, perché è uno dei punti dove
il consiglio classico è invecchiato male.
4.6 SMART e TBW: il libretto sanitario e il contachilometri
Due sigle che incontrerai su ogni scheda tecnica:
SMART è il sistema di auto-diagnosi del disco: una serie di contatori
interni (temperatura, errori, percentuale di vita consumata) che puoi leggere con programmi
gratuiti come CrystalDiskInfo. È il libretto sanitario del disco — utile, ma compilato dal
disco stesso, quindi affidabile quanto il firmware che lo scrive. (Anche qui: aspetta di
leggere la storia del 990 Pro.)
TBW (Terabytes Written) è il totale di dati che il produttore
garantisce di poter scrivere sul disco prima che la garanzia decada. Un disco da
"600 TBW" è coperto fino a 600 terabyte scritti. Sembra un indicatore di durata; vedremo che è
soprattutto una clausola legale — e, usato bene, una spia per smascherare fregature.
4.7 Interfacce e formati, in trenta secondi
Per completezza, le sigle di contorno: SATA è l'interfaccia vecchia (max
~550 MB/s), sopravvive negli aggiornamenti di PC datati. NVMe è il protocollo
moderno che viaggia su PCIe (la stessa autostrada delle schede video); le
generazioni PCIe 3.0/4.0/5.0 raddoppiano la banda a ogni salto. Il formato fisico dominante è
M.2 2280, la "stecca di gomma americana" da 8 cm che si avvita sulla scheda
madre. Nulla di tutto ciò determina l'affidabilità: sono i tubi, non l'acqua.
Capitolo 5 — Il duello: la checklist di Mokosiy sotto il bisturi di Afonin
Ora hai tutto il vocabolario. Ecco la checklist originale di Atola, voce per voce, con la
replica di Elcomsoft e — dove serve — le nostre verifiche indipendenti. Il formato è:
consiglio → dov'è la fregatura → come ci si difende davvero.
5.1 "Evita la QLC, preferisci la TLC"
Il consiglio è giusto. Il problema è che non sai cosa stai comprando.
Afonin porta le prove di un fenomeno sistematico: i produttori cambiano tipo di NAND tra un
lotto e l'altro, a metà produzione, oppure — mossa da manuale — mettono TLC sui tagli
piccoli e QLC sul taglio grande, cioè quello che compra chi cerca "un disco capiente".
Il WD Blue SN5000 monta TLC su 500 GB, 1 TB e 2 TB, e QLC sul 4 TB. La trappola era così ben
congegnata che, riferisce Afonin, persino PCWorld dovette correggere pubblicamente la propria
recensione nell'agosto 2025, dopo aver classificato il 4 TB come TLC. Il successore SN5100 è
poi passato interamente a QLC, senza squilli di tromba. Stesso schema sul Patriot Viper VP4300
Lite: TLC ovunque, QLC sul 4 TB.
La domanda retorica di Afonin è la chiave di tutto l'articolo: se sbagliano le testate il
cui mestiere è accorgersene, che possibilità ha il compratore davanti al carrello?
Difesa pratica: verificare cosa c'è dentro, non cosa dice l'etichetta.
Esistono tool gratuiti ("Flash ID") che interrogano il disco e rivelano controller e NAND
reali: SSD utils per Windows,
equivalente per Linux.
In alternativa: recensioni con smontaggio fotografico (TechPowerUp è tra le poche testate che
aprono fisicamente i dischi). E sempre: controllare la scheda tecnica del
taglio specifico che stai comprando, non del modello in generale.
5.2 "Evita i marchi economici: usano componenti scadenti e aggiornano male i firmware"
E quali sarebbero, i marchi economici? Afonin demolisce il criterio con tre
controesempi che vale la pena raccontare per esteso, perché sono un corso accelerato di
scetticismo.
Kingston è un marchio economico? La sua linea budget NV1/NV2 è una lotteria
hardware documentata: sotto lo stesso identico codice prodotto convivono controller diversi
(Phison oppure Silicon Motion), NAND TLC oppure QLC, sempre senza DRAM — e Kingston dichiara
solo le velocità sequenziali che qualunque combinazione raggiunge (grazie alla cache pSLC del
capitolo 4.4, ora sai come fanno). Compri la scatola e non sai cosa c'è dentro. "E allora spendo
di più e prendo il flagship!" Ecco il colpo di teatro: anche il top di gamma
KC3000/Fury Renegade tira i dadi
— alcune unità montano NAND Micron a 176 strati, altre NAND Kioxia più vecchia a 112 strati, e
l'unico modo per saperlo prima di aprire il disco è decifrare la stringa firmware sull'etichetta
(EIFK31.x = Micron, EIFK51.2 = Kioxia). Stesso disco, stesso prezzo, stessa scatola, silicio
diverso.
Western Digital è un buon marchio? Certamente. È anche il marchio che a giugno
2021
sostituì in silenzio la NAND
del suo popolarissimo SN550 — un disco osannato dalle recensioni — con una versione più lenta,
aggiornando furtivamente il datasheet. Risultato: a cache esaurita, la velocità di scrittura
crollava
da ~610 a ~390 MB/s, meno della metà.
Chi comprava sulla base delle recensioni riceveva un disco diverso da quello recensito. WD
ammise e promise
di cambiare numero di modello per le modifiche future — dopo essere stata scoperta. E
non era un caso isolato: negli stessi anni Adata, Crucial, Silicon Power e persino Samsung
(970 EVO Plus) furono colti a spedire componenti diversi da quelli recensiti.
Samsung è un buon marchio? Il migliore, per reputazione. Ed è il protagonista
del caso firmware più clamoroso del decennio, che l'articolo originale cita come esempio horror.
Capitolo dedicato tra poco.
Morale: l'unità di misura della fiducia non è il marchio. È
il modello specifico, nella revisione specifica, del lotto specifico.
"Compra marchi affidabili" è un consiglio vero come "investi in azioni buone".
5.3 "Controlla il TBW: più è alto, meglio è"
Mezzo mito. Ricordi il capitolo 4.6? Il TBW è un tetto di
garanzia, non una previsione di durata: è fissato in modo prudenziale dall'ufficio
legale, e la stragrande maggioranza degli utenti domestici non ci arriverà mai neanche vicino
nell'intera vita del disco. Un utente normale scrive 10–20 TB all'anno; un disco da
600 TBW gli durerebbe, sulla carta, trent'anni. Ordinare i dischi per TBW è ordinare per la
colonna sbagliata.
L'uso furbo, suggerisce Afonin, è come spia: dividi il TBW per
la capacità. Se un taglio della gamma ha un rapporto TBW/TB stranamente più basso dei fratelli,
è un forte indizio che lì dentro c'è QLC non dichiarata — il 4 TB del SN5000, di nuovo, ha
un'endurance che non scala come i tagli TLC della stessa linea. Il TBW non ti dice quanto vivrà
il disco; a volte ti dice quando il produttore sta bluffando.
5.4 "Verifica la presenza di cache DRAM"
Consiglio dell'era SATA con i vestiti moderni, scrive Afonin. Come visto nel
capitolo 4.5, la DRAM serve a tenere la mapping table a portata di mano; era decisiva sui
vecchi dischi e lo è ancora sui controller budget deboli (che però soffrono comunque). Ma sugli
NVMe moderni l'HMB ha ridotto il divario a qualcosa che misuri nei benchmark e non senti
mai nell'uso. Un buon disco DRAM-less recente batte comodamente un disco più vecchio con
DRAM.
La DRAM vince nettamente solo a parità di tutto il resto — stessa generazione, stesso
controller, stessa NAND. È un lusso gradito se avanza budget, non una feature di
affidabilità, e non è la cosa da cui partire. Chi seleziona i dischi col filtro "ha la
DRAM?" sta ottimizzando la variabile sbagliata e ignorando quelle giuste (NAND e controller).
5.5 "Pretendi almeno 4 anni di garanzia"
Afonin corregge al rialzo: i dischi che valgono la pena ne hanno cinque.
Samsung serie Pro, WD Black, Kingston KC3000/Fury, la fascia alta Crucial, SK Hynix Platinum:
tutti 5 anni. La garanzia a 3 anni è il cartello "benvenuto nella fascia lotteria". La soglia
"almeno 4" non seleziona nulla: o cinque, o stai già scendendo di categoria.
(E ricorda dal Capitolo 1: la garanzia ti ridà un disco. I dati no. Sono due problemi
diversi con due soluzioni diverse.)
5.6 "Verifica che esistano tool per aggiornare il firmware"
Domanda giusta, metrica sbagliata. L'esistenza di un programma di
aggiornamento non dice nulla: ci sono modelli con tool ufficiale bellissimo e zero
aggiornamenti rilasciati in tutta la vita commerciale del prodotto, e modelli senza tool che ne
hanno ricevuto uno d'emergenza quando un bug grave ha costretto il produttore.
La domanda vera è: questo produttore, storicamente, rilascia le correzioni quando le
cose si rompono? E in quanto tempo? Il caso che Afonin cita è istruttivo: il flagship
SK Hynix Platinum P41 (e il gemello Solidigm P44 Pro) ha convissuto per anni con un bug della
cache pSLC — in certe condizioni la cache smetteva di svuotarsi e la velocità sostenuta si
dimezzava. Segnalazioni dal 2022; la correzione vera (firmware 51061A20) è arrivata
anni dopo. Il firmware è la rete di sicurezza degli SSD, ma la rete può metterci
settimane ad apparire. O anni. O mai.
5.7 "Se puoi permettertelo, prendi un SSD enterprise"
No — a meno che tu non abbia davvero carichi enterprise. Pagheresti per
condensatori anti-blackout, formati strani e profili di scrittura tarati su un datacenter che
non possiedi. E qui Afonin piazza l'osservazione che manda in cortocircuito la checklist:
una grossa fetta degli SSD enterprise moderni è QLC — proprio i modelli
datacenter ad altissima capacità (la linea Solidigm D5 arriva a decine di TB per disco, su
QLC). "Evita la QLC, però compra enterprise" è un consiglio che litiga con sé stesso.
Fregatura bonus: gli enterprise viaggiano su canali di vendita business. Al privato che li
compra al dettaglio, la garanzia del produttore spesso non viene riconosciuta:
resti con quella del negozio, tipicamente 1–2 anni. Altro che "pretendi 4+".
5.8 "Per i PCIe 4.0/5.0, pensa a dissipatore e flusso d'aria"
Riguarda la velocità, non la sopravvivenza. Il componente che scalda è il
controller, e quando scalda troppo il disco fa thermal throttling: rallenta
apposta, per proteggersi. È una feature, non un guasto: costa prestazioni, non
anni di vita. Il surriscaldamento catastrofico e prolungato è un'altra storia — ma se ci arrivi,
è l'intero case che ha un problema di raffreddamento, non il disco. E su un laptop il
dissipatore non ce lo metti comunque, quindi lì il consiglio produce solo ansia. Regola
spiccia: il dissipatore incluso nella scheda madre basta quasi sempre; se compri un Gen5
estremo sai già da solo che serve ferro serio.
Consiglio sano — con un punto cieco che lo rovescia: è quasi inutile proprio per i
dischi appena usciti, che sono esattamente quelli a massimo rischio di sorprese,
perché gli smontaggi indipendenti non esistono ancora. Il prodotto più fresco è quello meno
verificabile.
Corollario operativo: se l'affidabilità ti interessa davvero, non comprare mai un
modello appena lanciato. Lascia che gli entusiasti del day-one facciano da crash test
dummy per sei mesi. Ti perderai l'ebbrezza della novità; ti terrai i dati.
5.10 "Fai sempre il backup"
Vero. Ovvio. E — nota acida di Afonin — sterile come chiusura di checklist: chi legge è già
diviso in due campi, quelli che fanno backup e quelli che non hanno ancora perso dati,
e nessuno cambia campo per una riga in un blog post. Si cambia campo il giorno che succede.
(Dettaglio gustoso: persino la procedura ufficiale Samsung per correggere il 990 Pro
raccomandava di fare un'immagine del disco prima di aggiornare il firmware. Buon
consiglio; anche ammissione implicita.)
Noi il discorso serio lo abbiamo già fatto al Capitolo 2, dove appartiene: prima della
checklist, non in fondo. Backup 3-2-1, e soprattutto: test di restore,
cronometrati.
5.11 "Se compri in blocco, diversifica: controller, generazione NAND, finestra di produzione, firmware"
L'unica idea genuinamente non ovvia dell'articolo originale, e Afonin —
correttissimo — lo riconosce e le rende onore. È l'intuizione sul guasto correlato che
un laboratorio di recovery possiede per esperienza diretta: dischi identici (stesso controller,
stessa NAND, stesso firmware, stesso lotto) tendono a morire insieme, perché
condividono gli stessi difetti latenti. Un NAS o un rack di unità gemelle può spegnersi in
coro, ed è lo scenario in cui anche il RAID ti saluta — il RAID protegge dal guasto
indipendente, non da quello sincronizzato.
Se compri più dischi per la stessa macchina: mescola modelli, o almeno lotti e date di
produzione. Il caveat pratico di Afonin: diversificare significa moltiplicare il lavoro
investigativo per ogni modello in lista — ma se stai comprando a quella scala, è il tuo
mestiere farlo.
5.12 "Chiedi a un'AI di fare deep research sul modello"
Buona idea, a una condizione che decide tutto: l'AI deve cercare sul web
in tempo reale, non rispondere a memoria. Un modello che risponde dai propri dati di
addestramento ti darà risposte fluide, sicure di sé e vecchie: non sa nulla
della fix firmware uscita il mese scorso, dello swap di NAND avvenuto dopo il suo
addestramento, del thread di guasti di ieri. E su un tema dove l'intera partita si gioca su
quale revisione, quale firmware, quale lotto, un'informazione stantia non è neutra: è
attivamente fuorviante, con in più il tono rassicurante. Pretendi le fonti linkate e le date.
Capitolo 6 — Il caso Samsung 990 Pro: la storia che dimostra il contrario di ciò che dovrebbe
Questa storia merita un capitolo suo, perché è il perno logico di tutto il duello — e perché,
capita questa, hai capito il mestiere.
L'uso che ne fa Mokosiy: esempio numero uno della tesi "gli SSD muoiono
all'improvviso e senza preavviso".
Lo smontaggio di Afonin, in quattro colpi:
Il 990 Pro passa l'intera checklist a pieni voti. TLC di punta, DRAM a
bordo, 5 anni di garanzia, tool firmware ufficiale (Samsung Magician), il marchio consumer più
reputato del pianeta. Se la checklist non intercetta nemmeno il proprio caso horror da
copertina, a cosa serve la checklist?
È una storia chiusa da tre anni. Citarla nel 2026 come monito attuale è
come sconsigliare un'auto per un richiamo risolto tre model year fa.
Dimostra l'esatto contrario della "morte silenziosa". Il disco non stava
morendo in silenzio: stava urlando — via SMART, forte, presto e per giunta esagerando.
Il degrado era in gran parte un errore di conteggio, non usura reale. Un caso di
falso allarme rumorosissimo usato come prova del silenzio.
Prova la lezione giusta, che è un'altra: il firmware è l'anima del disco e
la sua rete di sicurezza. Samsung ci ha messo poche settimane a riparare. SK Hynix, sul bug
del P41, anni. Il criterio d'acquisto non è "esiste un tool di aggiornamento?" ma "questo
produttore, quando le cose si rompono, quanto ci mette a sistemarle?"
Capitolo 7 — Il catalogo delle fregature (da tenere sul telefono al momento dell'acquisto)
Il numero grosso sulla scatola è la cache, non il disco. "7.400 MB/s"
vale finché scrivi nella cache pSLC. La velocità sostenuta — quella delle copie grosse —
spesso non è dichiarata affatto.
Stesso nome, hardware diverso. Il cambio di componenti dopo le recensioni
è pratica di settore documentata (WD SN550, Samsung 970 EVO Plus, Kingston NV2, Adata,
Crucial, Patriot…). Le recensioni valgono per il lotto recensito.
La QLC nascosta nel taglio grande. TLC sui tagli piccoli (quelli
recensiti), QLC sul 4 TB (quello che compri). Verifica sempre la scheda del taglio
specifico.
Il TBW come specchietto. Sbandierato quando è alto (ma è solo una
clausola di garanzia), sepolto in un PDF quando è basso (perché tradirebbe la QLC). Usa il
rapporto TBW/TB come rilevatore di bluff.
"Fino a" davanti a ogni numero. Massimi teorici, cache vuota, condizioni
di laboratorio.
Garanzia ≠ dati. La garanzia ti rende un disco vuoto. I dati erano il
punto. E se compri enterprise al dettaglio, forse non hai nemmeno quella.
Se costa di meno, c'è un perché. Non sei più furbo tu (Capitolo 3). Il
risparmio si è trasformato in qualcosa che scoprirai poi.
Capitolo 8 — La procedura d'acquisto, passo per passo
Parti dal tuo uso reale, non dai numeri. Disco di sistema e gaming?
Qualsiasi buon TLC va benissimo, DRAM facoltativa. Video, macchine virtuali, grossi
trasferimenti frequenti? TLC obbligatoria, controller di fascia alta, e guarda i grafici di
scrittura sostenuta nelle recensioni. Archivio che scrivi una volta e leggi per anni?
Va bene anche QLC dichiarata e pagata come tale — con il backup del Capitolo 2, sempre.
Seleziona 2–3 candidati con 5 anni di garanzia. Non quattro: cinque.
Per ciascun candidato, verifica il taglio esatto che comprerai: tipo di
NAND e controller dichiarati per quel taglio; rapporto TBW/TB confrontato con gli
altri tagli della gamma (se crolla, annusa la QLC).
Indaga il modello, non il marchio. Cerca "nome modello + NAND swap", "+
firmware issue", "+ teardown". Fonti che smontano davvero: TechPowerUp; poi Tom's Hardware,
r/buildapc, r/hardware, HDDGuru per i pattern di guasto.
Niente modelli appena usciti. Sei mesi di quarantena: lascia i crash test
agli entusiasti.
Quando il disco arriva, verificalo. CrystalDiskInfo per firmware e SMART;
un tool Flash ID (Windows / Linux) per vedere controller e NAND reali; una copia di file ben
più grande della cache per misurare la velocità sostenuta. Non corrisponde alla pubblicità?
Reso, finché sei nei termini. È l'unico voto che i produttori contano
davvero.
Aggiorna subito il firmware con il tool ufficiale (dopo il backup,
ovviamente), e ricontrolla ogni qualche mese.
Backup 3-2-1 e test di restore cronometrati. È il punto che funziona
anche quando tutti gli altri falliscono. Rileggi il Capitolo 2 finché non fa male.
Più dischi sulla stessa macchina? Diversifica: modelli, controller, o
almeno lotti e date di produzione diversi. I gemelli muoiono insieme.
Epilogo
I due articoli, letti insieme, insegnano una cosa sola detta in due modi. Mokosiy:
l'affidabilità si sceglie con criteri, non con la fortuna. Afonin: i criteri senza
verifica sono fortuna con la giacca buona.
E noi aggiungiamo il fondamento che serve al lettore italiano ancora mentalmente tarato sul
caro vecchio disco che frullava: il mondo è cambiato. Il disco nuovo è
meraviglioso, ma quando muore non lascia quasi mai ostaggi vivi. Quindi l'unità di fiducia non
è il marchio ma il modello-revisione-firmware-lotto; il prezzo basso è un messaggio, non un
regalo; e il vero acquisto che stai facendo non è un disco — è la coppia
disco + strategia di restore. Il primo si sceglie con questa guida. La seconda
si testa con un cronometro, prima che arrivi la fatina sbagliata.
Fonti
Oleg Afonin, How to Buy a Reliable SSD, Continued, Elcomsoft, 02/07/2026 —
blog.elcomsoft.com
Vitaliy Mokosiy, How to buy a reliable SSD, Atola/LinkedIn —
linkedin.com
Nota per la redazione: verificare se pubblicare anche un collegamento incrociato alla
versione sintetica di questo articolo, una volta online, per chi preferisce una lettura più
breve.
Domande frequenti
Qual è la differenza tra la checklist di Mokosiy e la critica di Afonin?
Mokosiy propone una checklist di dodici punti per comprare SSD affidabili. Afonin non la
contraddice, ma mostra che ogni singolo punto, pur essendo vero, nasconde dettagli pratici che
la checklist da sola non copre, come il taglio specifico del disco, il lotto di produzione e la
storia degli aggiornamenti firmware del produttore.
Conviene comprare sempre memoria TLC invece di QLC?
Non sempre. La TLC è preferibile per usi intensivi come video editing o macchine virtuali. La
QLC va benissimo per un archivio che si scrive una volta e si legge nel tempo, purché sia
dichiarata come tale e accompagnata da un backup serio, invece di essere venduta senza
dirlo al posto della TLC.
Quanti anni di garanzia dovrei pretendere da un SSD?
Secondo Afonin, i dischi che valgono davvero la pena offrono cinque anni di garanzia, non
quattro. Una garanzia di tre anni è spesso il segnale di essere entrati nella fascia di prodotti
più soggetta a variazioni impreviste di componenti.
Cos'è la cache pSLC e perché la velocità sulla scatola può ingannare?
È una porzione di memoria che lavora temporaneamente in modalità più veloce per dare
l'impressione di prestazioni elevate. La velocità dichiarata sulla confezione vale solo finché si
scrive dentro questa cache: una volta esaurita, il disco scrive alla sua velocità reale, che può
essere molto più bassa, soprattutto sui dischi QLC.
Il caso Samsung 990 Pro significa che i dischi Samsung non sono affidabili?
No, è vero il contrario. Il caso dimostra che anche un disco che rispetta ogni singolo criterio
di una checklist solida, marchio reputato compreso, può avere un problema serio. Ma dimostra
anche che Samsung ha risolto il problema in poche settimane con un aggiornamento firmware,
il che è proprio il criterio di affidabilità che conta di più secondo questo articolo.
Qual è l'unico punto della checklist che conta davvero, secondo gli autori?
Il backup 3-2-1 con test di restore cronometrati. È l'unico punto che, come scrivono gli
autori, funziona anche quando tutti gli altri criteri di scelta falliscono o si rivelano
insufficienti.
Le persone chiedono anche
Gli SSD si rompono senza preavviso?
Spesso sì. A differenza dei vecchi dischi rigidi meccanici, che di solito davano segnali come
rumori o rallentamenti prima di guastarsi, un SSD può smettere di funzionare da un momento
all'altro, senza alcun avviso precedente.
È vero che i dati di un SSD rotto non si possono recuperare?
Il recupero è molto più difficile che sui vecchi hard disk. I dati sono cifrati e sparpagliati su
più chip di memoria secondo una mappa gestita dal controller: se il controller si guasta, quella
mappa si perde, e il recupero, quando possibile, richiede laboratori specializzati con costi
elevati e nessuna garanzia di successo.
Cosa significa TBW su un SSD?
TBW sta per Terabytes Written, il totale di dati che il produttore garantisce di poter scrivere
sul disco prima che la garanzia decada. È soprattutto una clausola legale, non una previsione
realistica di quanto durerà il disco nell'uso quotidiano.
Meglio un SSD con o senza DRAM a bordo?
Sui dischi NVMe moderni la differenza è minima, perché la tecnologia HMB permette anche ai
dischi senza DRAM di usare una parte della memoria del computer per lo stesso scopo. La DRAM
resta un vantaggio solo a parità di tutto il resto, non un requisito di affidabilità.
Come faccio a sapere che memoria ha davvero il mio SSD?
Esistono strumenti gratuiti, chiamati Flash ID, che interrogano direttamente il disco e
rivelano il controller e il tipo di memoria reali, indipendentemente da cosa dichiara l'etichetta
o la scheda tecnica generica del modello.
Quanto dura in media un SSD?
Dipende dal tipo di memoria e dall'uso. Per un utente domestico medio, che scrive pochi
terabyte all'anno, la durata teorica di un buon disco si misura in decenni sulla carta. Il vero
rischio non è quasi mai l'usura della memoria, ma un guasto improvviso del controller o un bug
di firmware.
Preferisci non dover verificare tutto questo da solo, ogni volta?
Alchimie Digitali affianca aziende e professionisti nella scelta dell'hardware, nella
progettazione di strategie di backup e disaster recovery davvero testate, e nella valutazione
delle vulnerabilità della propria infrastruttura IT.
Analisi preliminare sulla sicurezza aziendale. La maggior parte delle PMI italiane affronta rischi informatici concreti senza aver mai eseguito una valutazione strutturata. Cyber Audit, Vulnerability Assessment e Penetration Test non sono sinonimi: confonderli può esporre l'organizzazione a lacune gravi, sia tecniche che normative.
Quando un'azienda decide di investire in cybersecurity, si trova spesso davanti a tre termini che circolano in modo intercambiabile: Cyber Audit, Vulnerability Assessment e Penetration Test. In realtà, si tratta di attività profondamente diverse per obiettivi, metodologie e profondità di analisi. Scegliere lo strumento sbagliato — o peggio, saltarne uno — significa operare con una visione parziale del proprio livello di esposizione al rischio.
Questa guida è pensata per chi si trova all'inizio di un percorso di maturità in sicurezza informatica: chiunque gestisca un'infrastruttura aziendale, anche piccola, ha bisogno di sapere da dove iniziare e perché.
Primo strumento
Cos'è un Cyber Audit e quando è il punto di partenza giusto
Il Cyber Audit è una valutazione complessiva e strutturata dello stato di sicurezza informatica dell'organizzazione. Non si limita all'infrastruttura tecnica: analizza l'intero ecosistema aziendale, includendo processi, policy, comportamenti del personale e conformità normativa.
Nel dettaglio, un Cyber Audit esamina:
infrastruttura IT e rete aziendale
gestione degli accessi e delle identità digitali
politiche di backup e continuità operativa
protezione dei dati e trattamento secondo il GDPR
formazione e consapevolezza del personale
procedure interne e conformità normativa (NIS2, CRA)
Il risultato non è un elenco di vulnerabilità tecniche, ma una fotografia del livello di maturità della sicurezza dell'intera organizzazione, con indicazioni strategiche chiare sulle aree di intervento prioritarie.
Perché iniziare dal Cyber Audit?
Perché senza una visione d'insieme, qualsiasi investimento tecnico successivo — Vulnerability Assessment, Penetration Test, formazione — rischia di essere decontestualizzato. Il Cyber Audit è la mappa prima di qualsiasi percorso.
Cos'è un Vulnerability Assessment e cosa individua concretamente
Il Vulnerability Assessment è un'attività tecnica mirata. A differenza del Cyber Audit, che ha una prospettiva organizzativa e strategica, il VA si concentra sull'identificazione sistematica delle debolezze presenti su sistemi, server, apparati di rete e servizi esposti.
La domanda a cui risponde è precisa: «Quali punti deboli esistono oggi nella mia infrastruttura?»
Attraverso strumenti professionali e metodologie standardizzate vengono rilevate vulnerabilità note (CVE), configurazioni errate, servizi esposti non necessari, software obsoleti e credenziali deboli. Il risultato è un report tecnico dettagliato con le criticità ordinate per priorità di intervento.
Nota bene: un Vulnerability Assessment individua le vulnerabilità ma non verifica se queste possano essere realmente sfruttate per compromettere i sistemi. Quel passo successivo è il Penetration Test.
Cos'è un Penetration Test e come simula un attacco reale
Il Penetration Test — spesso chiamato pen test — è l'attività più approfondita e invasiva tra le tre. Non si limita a censire le vulnerabilità: le utilizza attivamente per simulare il comportamento di un attaccante reale e valutare la concreta capacità dell'infrastruttura di resistere a una compromissione.
Se il Vulnerability Assessment risponde a «dove sono vulnerabile?», il Penetration Test risponde a «quanto è concretamente sfruttabile quella vulnerabilità?». La differenza non è semantica: è operativa. Una vulnerabilità tecnica teorica può avere impatto molto diverso a seconda del contesto architetturale, dei controlli esistenti e della segmentazione della rete.
I Penetration Test possono essere condotti su perimetri specifici — applicazioni web, reti interne, endpoint, infrastrutture cloud — con approcci black box, grey box o white box, a seconda del livello di informazione fornito al team di test.
Le differenze in sintesi: tabella comparativa
Attività
Obiettivo principale
Profilo
Output
Cyber Audit
Valutazione complessiva del livello di sicurezza aziendale
Strategico
Report di maturità + piano di intervento
Vulnerability Assessment
Individuazione sistematica delle vulnerabilità tecniche
Tecnico
Report vulnerabilità per priorità
Penetration Test
Simulazione di un attacco reale e verifica dello sfruttamento
Operativo
Report di compromissione + remediation
Audit + VA combinati
Visione strategica e tecnica integrata
Completo
Piano completo di sicurezza aziendale
Quale attività scegliere? Dipende dalla situazione di partenza
Non esiste una risposta universale, ma esistono criteri chiari per orientarsi.
1
Nessuna verifica strutturata precedente
Inizia con un Cyber Audit. Otterrai una fotografia completa dell'organizzazione e una mappa delle priorità da cui costruire qualsiasi percorso successivo in modo coerente.
2
Vuoi sapere dove sono le vulnerabilità tecniche
Il Vulnerability Assessment è lo strumento indicato. È misurabile, ripetibile e restituisce un quadro tecnico preciso dell'esposizione dell'infrastruttura.
3
Vuoi testare la reale resistenza a un attacco
Il Penetration Test è l'attività giusta. È l'unica che verifica non solo la presenza di vulnerabilità ma la loro concreta sfruttabilità in uno scenario offensivo simulato.
4
Approccio ottimale per la maggior parte delle aziende
La combinazione più efficace è: Cyber Audit → Vulnerability Assessment → Penetration Test. Non sono alternative, sono fasi progressive di un percorso di maturità in cybersecurity.
Domande frequenti su Cyber Audit, Vulnerability Assessment e Penetration Test
Un Cyber Audit sostituisce un Vulnerability Assessment?
No. Il Cyber Audit ha una dimensione organizzativa e strategica: valuta governance, processi, policy e conformità normativa. Il Vulnerability Assessment si concentra sugli aspetti tecnici dell'infrastruttura. Sono complementari, non intercambiabili.
Un Vulnerability Assessment è sufficiente per essere conformi alla NIS2?
No. La Direttiva NIS2 richiede un approccio molto più ampio che comprende governance della sicurezza, gestione degli incidenti, continuità operativa, sicurezza della supply chain e formazione del personale. Il Vulnerability Assessment è uno strumento tecnico, non un percorso di conformità normativa completo.
Con quale frequenza andrebbe eseguito un Cyber Audit?
Almeno una volta all'anno, oppure in occasione di cambiamenti significativi dell'infrastruttura aziendale — nuovi sistemi, acquisizioni, migrazioni cloud, ampliamenti della rete. Alcuni framework normativi, come NIS2, implicano una revisione continua del livello di rischio.
Cyber Audit e Vulnerability Assessment possono essere svolti insieme?
Sì, ed è spesso la soluzione più efficace. La combinazione restituisce sia la visione strategica dell'organizzazione sia la fotografia tecnica dettagliata dell'infrastruttura, permettendo di costruire un piano di miglioramento coerente su entrambi i livelli.
Qual è la differenza concreta tra Vulnerability Assessment e Penetration Test?
Il Vulnerability Assessment identifica e cataloga le vulnerabilità presenti nell'infrastruttura. Il Penetration Test va oltre: verifica se quelle vulnerabilità siano realmente sfruttabili da un attaccante per compromettere sistemi, dati o servizi. Il primo fotografa l'esposizione, il secondo la mette alla prova.
La sicurezza informatica non si improvvisa: si costruisce per livelli.
Cyber Audit, Vulnerability Assessment e Penetration Test non sono alternative tra cui scegliere in base al budget: sono strumenti che rispondono a domande diverse e vanno usati in sequenza logica. Chi parte senza una mappa strategica investe male. Chi si ferma alla mappa senza verificare i dettagli tecnici si illude di essere al sicuro.
Alchimie Digitali affianca le aziende in ogni fase di questo percorso, dalla prima analisi preliminare fino alle attività operative di verifica e remediation.